
我写了 wcode:把 Web AI 接到本地代码库
本文目录13 个章节
这篇保留的是 wcode 第一版的实现状态,我不会跟着后续代码逐段回写。现在的版本已经继续做了 Design State、Product Scope、Verification、Evidence、Reconciliation 和 Project Observatory,见 wcode 最近做成什么样了。
我平时会同时用几个 AI 的 Web 端。它们的模型和对话体验已经很好了,但一碰到本地项目,事情就变得很别扭:要么手动复制代码,要么换到另一个 Coding Agent,要么再申请 API Key、单独付一份 Token 账单。
但我并不想再造一个 Agent。
模型、上下文管理和 Agent Loop,Web 端都已经有了。我缺的只是一根管子,让它能在我允许的范围内读写本地代码。于是有了 wcode:一个用 Rust 写的 Remote MCP Bridge。
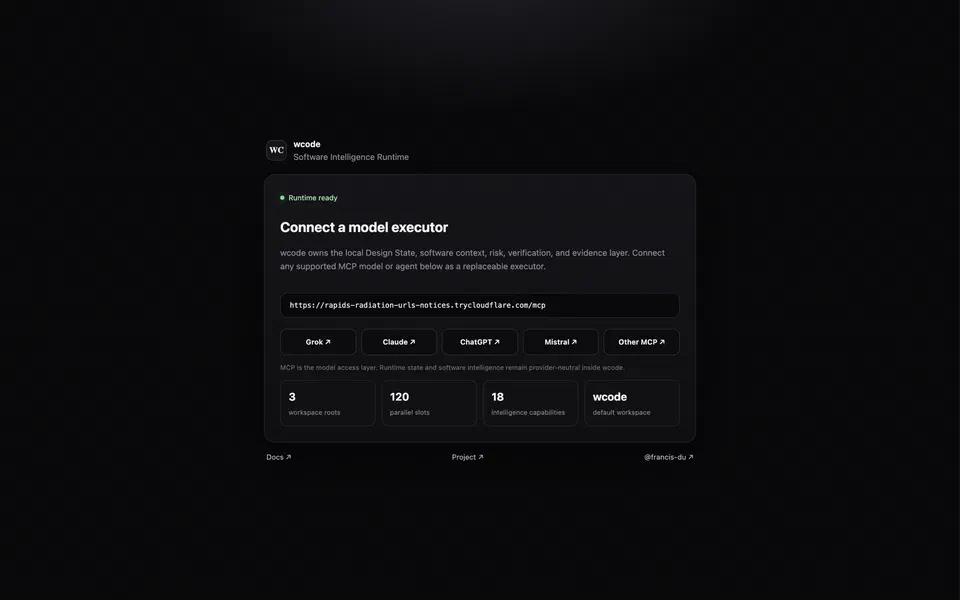
在项目目录里运行一个二进制,它会启动本地 MCP Server、OAuth、HTTPS Tunnel、配置页和终端监控。然后把生成的 /mcp 地址加到 Grok、Claude、ChatGPT、Mistral 或其他支持 Remote MCP 的客户端里,就可以直接聊本地代码。
还有一个很现实的用法:薅 Web 端。
如果一个 Web 产品允许在对话里接入自定义 MCP,那么模型继续用 Web 端提供的能力,代码搜索、读取、修改和验证则由本机的 wcode 完成。这样不需要为了 Code Agent 再配一套模型 API Key,也没有额外的按量 API Token 账单。
这不是绕过平台限制。模型回复仍然受 Web 端自己的套餐、消息数、Credits、速率或上下文规则约束。准确地说,wcode 省掉的是“为了让 AI 访问本地代码,再买一份 API Token”的成本。
wcode 只做桥接#
我一开始就给它定了边界:不负责选模型,不负责实现 Agent Loop,也不保存聊天记录。它只把 MCP 请求转换成受控的本地代码操作。
Web AI / Coding Agent
          │
          │  Remote MCP + OAuth
          ▼
┌──────────────────────────────┐
│            wcode             │
│                              │
│ Auth ─ MCP ─ Tool Harness    │
│                 │            │
│       Code Index / Workspace │
└─────────────────┬────────────┘
                  │
                  ▼
          指定的代码目录
网络层用 Axum 和 Tokio,终端界面用 Ratatui,代码索引用 Tree-sitter。最后编译成一个原生二进制,没有数据库,也没有另外一组常驻服务。
源码里的模块基本就是按照边界拆的:auth.rs 管 OAuth,mcp.rs 管协议和工具路由,workspace.rs 管文件与命令安全,code_index.rs 管语法索引,harness.rs 管并发和项目级工作流,monitor.rs 只记录并展示真实任务。
启动时三个 Axum Router 会合到一起:
let app = auth::router(auth.clone())
    .merge(mcp::router(app_state))
    .merge(control_router);

let server_task = tokio::spawn(async move {
    axum::serve(listener, app).await
});
本地 Server 先启动,公网 Tunnel 后启动。这样即使 Cloudflare DNS 或 TLS 还在预热,本地服务和公网问题也不会搅在一起。
一次 MCP 请求怎么进来#
wcode 的 /mcp 不是拿到 URL 就能调用。一个请求真正进入工具层之前,要依次过四关:
Origin 是否匹配
        ↓
Bearer Token 是否有效,并绑定当前 Resource
        ↓
MCP 协议版本是否支持
        ↓
Header、JSON-RPC method、_meta 是否一致
        ↓
tools/list 或 tools/call
MCP 生态还在快速变化,各个客户端升级并不同步。所以 wcode 里保留了两条路径:新协议走无状态 POST,老客户端仍然可以通过 initialize 握手连接。未知版本会明确报错并返回支持的版本,不会悄悄猜一个版本继续跑。
如果 HTTP 请求里带了 Origin,wcode 会检查 Scheme、Host 和有效端口是否与公开 MCP 地址一致,同时拒绝额外的 Path、Query 和 Fragment。这不是普通的 CORS 装饰,主要是为了降低本地 HTTP Transport 被 DNS Rebinding 利用的风险。
新协议的请求还会交叉检查 Mcp-Method Header 和 JSON-RPC 的 method。调用工具时,Mcp-Name 也必须和 params.name 对得上。协议边界宁愿多拒绝一次,也不应该模糊地接受两个互相矛盾的路由信息。
OAuth 为什么放在本地#
Grok、Claude 这类云端产品访问不到 127.0.0.1,所以 wcode 默认会用 Cloudflare Quick Tunnel 创建临时 HTTPS 地址。但 Tunnel 只解决网络可达性,不负责授权。
第一次访问 /mcp,客户端会得到 401 和 Protected Resource Metadata 地址:
HTTP/1.1 401 Unauthorized
WWW-Authenticate: Bearer resource_metadata="https://…/.well-known/oauth-protected-resource/mcp", scope="mcp"
后面的流程是标准 OAuth 2.1 + PKCE:客户端发现元数据、注册、打开授权页、交换 Authorization Code,最后拿到绑定当前 /mcp Resource 的 Token。
Client          /mcp          OAuth          Browser
  │               │             │               │
  ├─ POST ───────►│             │               │
  │◄─ 401 + metadata ────────────┤               │
  ├──────── register ───────────►│               │
  ├──────── authorize + PKCE ───►├─ pairing ────►│
  ├──────── exchange code ──────►│               │
  │◄──────── access token ───────┤               │
  └─ Bearer + tools/call ───────►│               │
授权页还要输入终端显示的六位验证码。只拿到临时公网 URL 的人,不能直接替你授权。Authorization Code 是单次、短时的,Refresh Token 会轮换,Redirect URI 只接受 HTTPS 或受约束的 Loopback 地址。
MCP 新版更推荐 Client ID Metadata Document,但我没有默认抓取客户端随便给出的 Metadata URL。自动化是多了一点,同时也新开了一个出站网络、SSRF 和 DNS Rebinding 的口子。在没有完整处理这个信任边界之前,我更愿意保留 DCR 兼容路径。
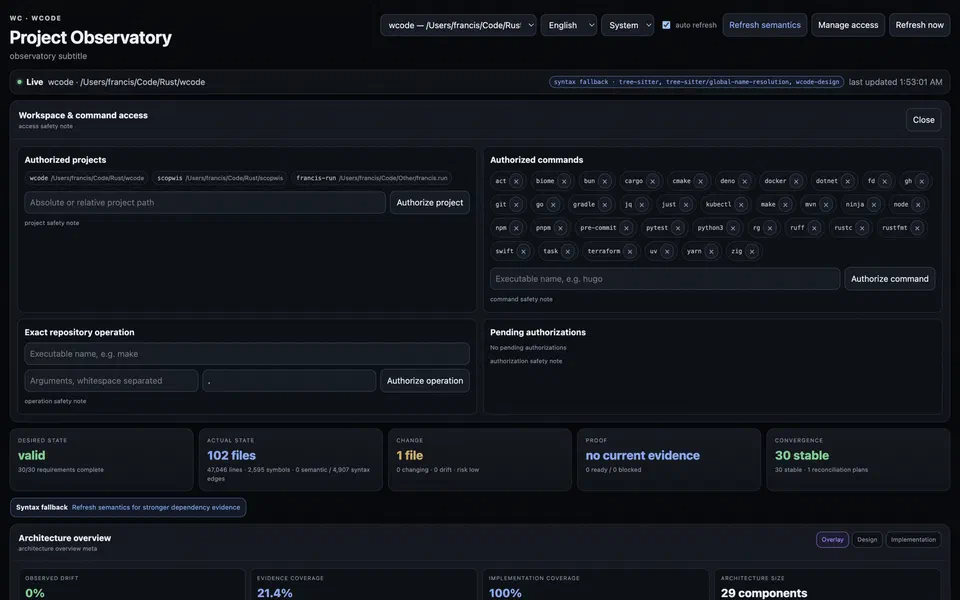
授权面板把项目、命令白名单和精确仓库操作的授权放在本地显式管理,模型不能批准自己的请求:
文件沙箱最麻烦的不是 ../#
最早写 Workspace 层时,我很快发现:检查一下路径里有没有 ..,离“只能访问这个目录”还差得很远。
每个工作区在启动时都会先 canonicalize。文件系统根目录、Home 目录这类范围过大的 Root 默认拒绝;多个工作区如果是父子关系,也默认拒绝。在 Unix 上,wcode 还会记住 Root 的 Device/Inode。
每次文件操作之前,Root 都要重新解析并核对身份。如果服务启动后,同一路径被换成了另一个目录,即使字符串完全没变,操作也会中止并要求重启。
模型传进来的路径只能是相对路径,除此之外还会拒绝:
..、绝对路径和 Windows Prefix;- 含冒号的 Path Component,避免 Alternate Data Streams;
.git、.env*、密钥和常见凭据位置;- 路径中的任意 Symlink Component;
- Unix 上指向多处的 Hard Link 写入。
已有文件和新文件也不能用同一套解析逻辑。已有文件可以 Canonicalize 到最终目标,再确认它仍在 Root 内;新文件的叶子还不存在,只能先解析父目录,然后确认父目录没有逃出去。
读文件本身也有竞态。wcode 在读取前后各取一次 Metadata,比对长度和修改时间。如果中途变了,这次读取直接失败,让客户端重试。成功返回时会同时带一个 SHA-256,后续编辑必须使用它。
stat before → read → stat after → SHA-256
     │                 │
     └── 不相等就重试 ─┘
防止 AI 用旧上下文覆盖新代码#
假设模型读到了版本 A。在它思考的几秒里,我手动改成了版本 B。模型如果还按 A 去替换文本,很容易把我的改动一起覆盖掉。
wcode 的写入同时用了三层保护:请求携带读取时的 SHA-256;同一个文件的并发写入使用一把进程内锁;真正拿到锁以后,再重新解析路径、读取文件并检查哈希。
写入也不是直接 truncate 原文件。它会在相同目录创建一个 create_new 临时文件,写完 sync_all,继承原权限,再原子替换目标。Unix 走同文件系统的 rename;Windows 使用带 REPLACE_EXISTING 和 WRITE_THROUGH 的系统调用。最后再尽量同步父目录。
创建文件是另一条路径。临时文件会以 Create-new 语义落到目标位置;如果另一个任务恰好先创建了同名文件,这次请求失败,不会覆盖它。
另外我没有给模型 Delete Tool。大幅缩短现有文件也会被当成破坏性写入,除非用户显式开启 --allow-destructive-writes。这不保证 AI 永远不犯错,但能把最难恢复的错误挡在默认路径之外。
Tree-sitter 只承诺语法精度#
如果工具只有全文搜索和 read_file,模型很容易退化成“把整个文件发给我看看”。上下文浪费大,定位也不精确。
wcode 内置 Tree-sitter,提供三个语法级工具:
file_outline:列出定义、签名和准确范围;find_symbol:跨文件查找定义;symbol_context:围绕一个符号返回有限正文、嵌套定义和语法调用。
索引是 Lazy 的。只有真正请求某个文件或符号时才解析;目录搜索会先做便宜的文本预过滤,再对候选源码建树。完整 AST Cache 最多保留 128 个文件,目录符号搜索最多扫描 50,000 个源文件。写入成功后,对应的 Symbol Record 和 AST 会立即失效。
这里我刻意没有把结果包装成“语义理解”。所有模型可见的索引结果都写着:
{
  "provider": "tree-sitter",
  "precision": "syntax"
}
它能回答哪里定义了函数、语法上出现了哪些调用,但不假装自己做了宏展开、类型推断、重载选择或动态分派。对 Agent 工具来说,明确能力边界比伪造一个很强的答案更重要。
并发不是越满越好#
wcode 只有一个全局 Tokio Semaphore,所有真实工具任务都从这里拿 Permit。默认上限是逻辑 CPU 数的八倍,并 Clamp 到 64–128;也可以通过 -j 调整,内部硬上限是 256。
一条任务只走这几个状态:
queued → acquire permit → running → completed / failed
parallel_tools、review_changes 和 verify_project 这类组合工具有个容易踩的坑:父任务不能先占一个 Permit,再等子任务。否则当 -j 1 时,父任务拿走唯一槽位,子任务永远跑不起来。
所以组合工具本身不占父 Permit,每个真正做事的 Child 自己排队。parallel_tools 只允许 Read/Discovery 操作,最多 128 个子任务;单个结果最多 512 KiB,总响应最多 8 MiB。
另一方面,能一次遍历做完的工作没有必要强行并行。search_many 和 read_files 会优先做批量操作,减少 MCP Round Trip。互相依赖的编辑保持串行,Cargo Test、Clippy、Build 这类重任务也分阶段执行,避免一起争抢编译缓存。
TUI 里的 Slots 和 Peak 就来自这些真实 Permit,不是 UI 模拟出来的繁忙程度。
我不想给模型一个远程 Shell#
run_command 接收的是 Program 和 Argument Array,从来不经过 Shell。默认允许面很窄:受限制的 Git/ripgrep 只读操作,以及形状完全匹配的 cargo fmt --check、cargo check、cargo check --locked。
Git Mutation 始终阻止。子进程的 GIT_* 状态会被清理,交互式 Prompt、Helper、外部 Diff 以及能改变仓库发现范围的配置也会被拒绝。stdout/stderr 有上限,执行有 Timeout,敏感环境变量不会传进去。
为什么连 Build 和 Test 也不默认放开?因为 Cargo Build Script、Proc Macro、Makefile、Package Script 和测试代码都由仓库控制。“这是一个测试命令”不代表它安全。
项目级验证走 verify_project。Harness 会先识别 Cargo、Go、Node、Flutter、Make 等项目,再根据 Manifest 和仓库规则推导检查命令。只有通过 Exact-shape Validation 的命令,才会临时进入验证通道。便宜的检查可以重叠,编译重任务按阶段跑,返回给模型的诊断只保留有界尾部。
--allow-risky-exec 可以放宽命令策略,但它是一次明确的信任扩张,不是 OS Sandbox。我不希望为了让 Demo 看起来“什么都能跑”,把这个 Flag 默认打开。
Harness 不是一句 Prompt#
这里单独说一下 Harness,因为它不是在 System Prompt 里写一句“改完记得跑测试”。它是一层有状态、可执行、带边界的工程工作流。
模型第一次进入仓库,应该先调用 project_context。Harness 会查看根目录里的 Manifest 和 Lockfile,识别 Rust、Node、Python、Go、Make 等项目类型;同时按固定优先级读取 AGENTS.md、CLAUDE.md、README.md 一类仓库说明。每个文件有行数和字符上限,所有说明还有总字符预算,内容仍然经过 Workspace 的敏感信息脱敏。
识别结果会生成一个 ProjectProfile,里面包括项目类型、Manifest、仓库规则、推荐检查和默认工作流。例如发现 Cargo.toml 时,会推导:
quick: git diff --check
quick: cargo fmt --check
quick: cargo check --locked

full:  cargo test --locked
full:  cargo clippy --locked -- -D warnings
full:  cargo build --release --locked
如果存在 package.json,Harness 只读取实际存在的 lint、typecheck、check、format:check、test、build Script,并根据 Lockfile 选择 npm、pnpm、yarn 或 bun。Makefile 也只识别明确存在的 check、lint、test Target,不凭空猜命令。
Project Profile 会缓存,但不是永远不变。Fingerprint 来自 Manifest 和 Guidance 的 Metadata;这些文件变化后,下次请求会重新构建。构建发生在 Cache Lock 外面,避免一个大仓库的上下文发现阻塞其他 Workspace。写回缓存前再检查一次,解决并发请求重复构建时的竞态。
review_changes 也没有直接返回整份 Git Diff。它并行跑五个只读 Probe:
git status
unstaged numstat     staged numstat
unstaged diff-check  staged diff-check
Harness 把结果合并成文件列表、增删行数和风险分类。改了源码却没改测试、动了认证或 Token 文件、改了 Manifest、删了测试、碰了 Migration/Workflow,都会产生对应 Finding。变更超过 25 个文件或约 1,000 行会提示拆分;风险再高一些时,会直接推荐 Full Verification。这里最多分析 500 个文件、保留 64 条 Finding,避免一个巨大 Working Tree 把上下文打爆。
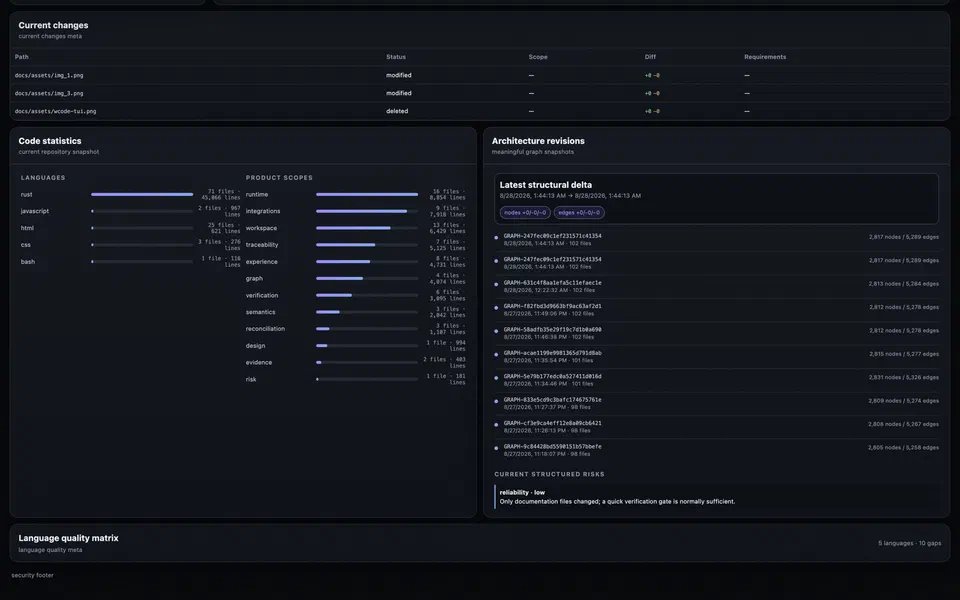
这些分析结果在 WebUI 里可以直接看到:当前变更、每个文件命中的 Requirement、代码统计和风险等级:
verify_project 接受 quick 或 full。它先把推导出的检查排序,再按 Phase 执行:
Phase 0  format / static check / diff check
   ↓ barrier
Phase 1  tests
   ↓ barrier
Phase 2  clippy
   ↓ barrier
Phase 3  release build
同一个 Phase 内彼此独立的检查可以并发,不同 Phase 之间有 Barrier。这样既不把所有命令串行到底,也不会让 Test、Clippy 和 Release Build 同时争 Cargo Cache。每个检查仍然单独获取全局 Semaphore Permit,单独进入 Monitor,并返回 Exit Code、耗时与截断后的 stdout/stderr 尾部。
最关键的是,verify_project 不能借“自动验证”绕过命令策略。推导出的 Program 和 Args 还要经过内部 Exact-shape Validator,只临时放行这一条已经识别的命令,再委托给同一个 Workspace Command Policy。Harness 提供的是一条更容易走对的路,不是第二个后门。
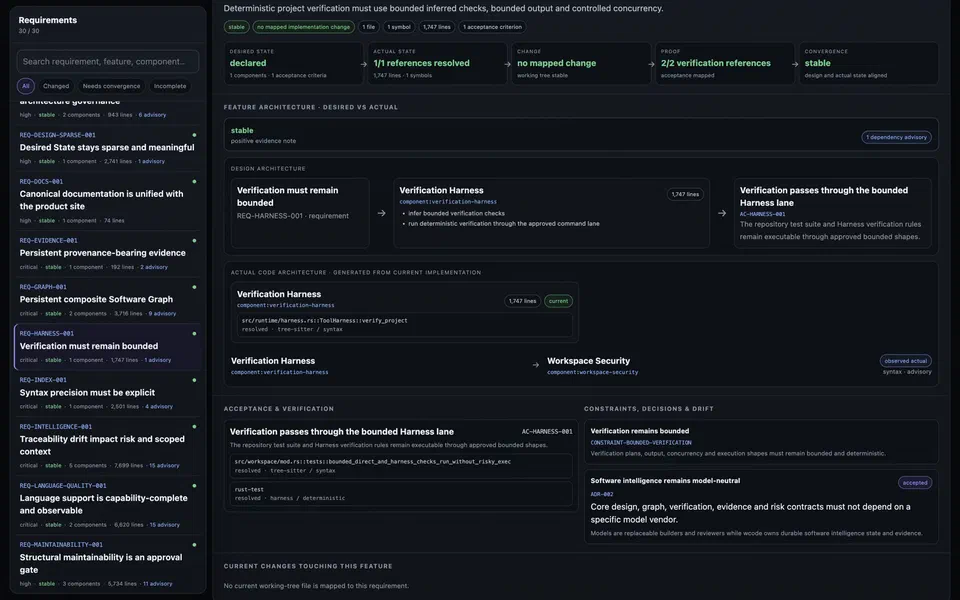
需求详情页把 Desired State → Actual State → Change → Proof → Convergence 排成一条链,验证证据挂在 Proof 一环:
Tunnel 挂了以后怎么办#
每个 wcode 进程都有一个随机 instance_id。cloudflared 输出公网 URL 后,wcode 不会立刻显示 Ready,而是从公网请求 /healthz。只有响应里的 ok 为真,并且 instance_id 与当前进程一致,才会打开 Setup Hub。
这个检查主要防两个问题:Tunnel 的 DNS/TLS 还没准备好;或者同一台机器上的另一个 wcode 实例恰好能响应,造成假就绪。
运行期间每 25 秒检查一次公网状态。连续失败三次,或者发现自己启动的 cloudflared 子进程退出,就把整个 Runtime 当成恢复边界:先恢复终端,再停健康任务和本地 Server,Kill 并 Wait 子进程,最后用原参数重新启动。
Quick Tunnel 重启后 URL 可能会变,所以 wcode 不会假装旧 OAuth 状态还能继续用。需要稳定地址时,应该配置自己的 Reverse Proxy,再通过 --public-url 交给 wcode。
wcode restart 和 wcode stop 复用了同一条 Graceful Shutdown 路径。控制接口有一枚 256-bit 本地随机 Token,保存在权限为 0600 的 Runtime File 中,并做 Constant-time Compare。因为这条 Route 也可能被公网反向代理带出去,所以“它只在本机用”不能成为免认证的理由。
TUI 展示的都是真实状态#
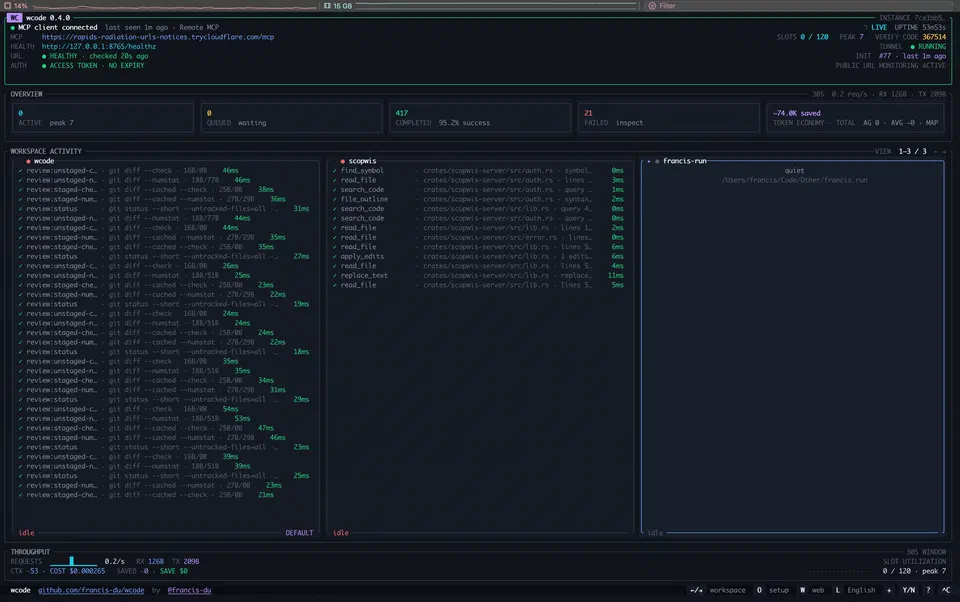
Ratatui 面板里有本地服务、公网 Tunnel、OAuth、MCP 最近活动、工作区任务、队列、Slots、Peak 和吞吐量。
这些数据来自同一个 TaskTicket 生命周期:收到请求时入队,拿到 Permit 时运行,返回时完成或失败。如果异步任务异常 Drop,Ticket 也会结束记录,不会在面板上永久留下一个 Running。
交互式终端使用 Alternate Screen 和 Raw Mode,并通过 RAII Guard 恢复鼠标捕获、光标和主屏幕。忙时大约 150 ms 刷新一次,闲时降到 500 ms。stdout 不是 TTY 或传入 --no-monitor 时,就退化成普通日志。
我不喜欢一些 Agent 产品为了显得很忙,凭空画出一堆并行任务。wcode 的原则很简单:没有发生的事,不显示。
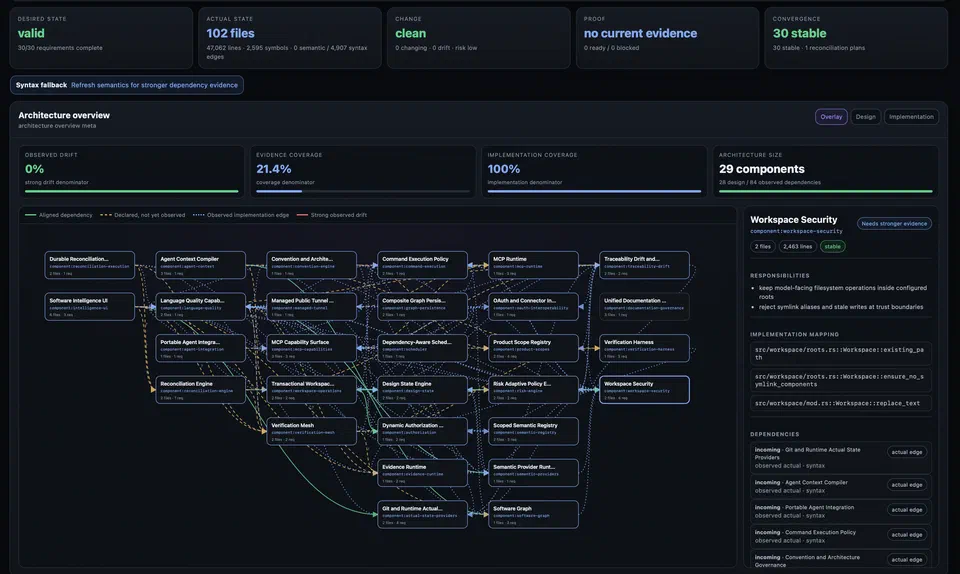
WebUI 侧遵循同一个原则。Project Observatory 把期望架构、实际依赖、漂移、证据与实现覆盖率放在同一个视图里:
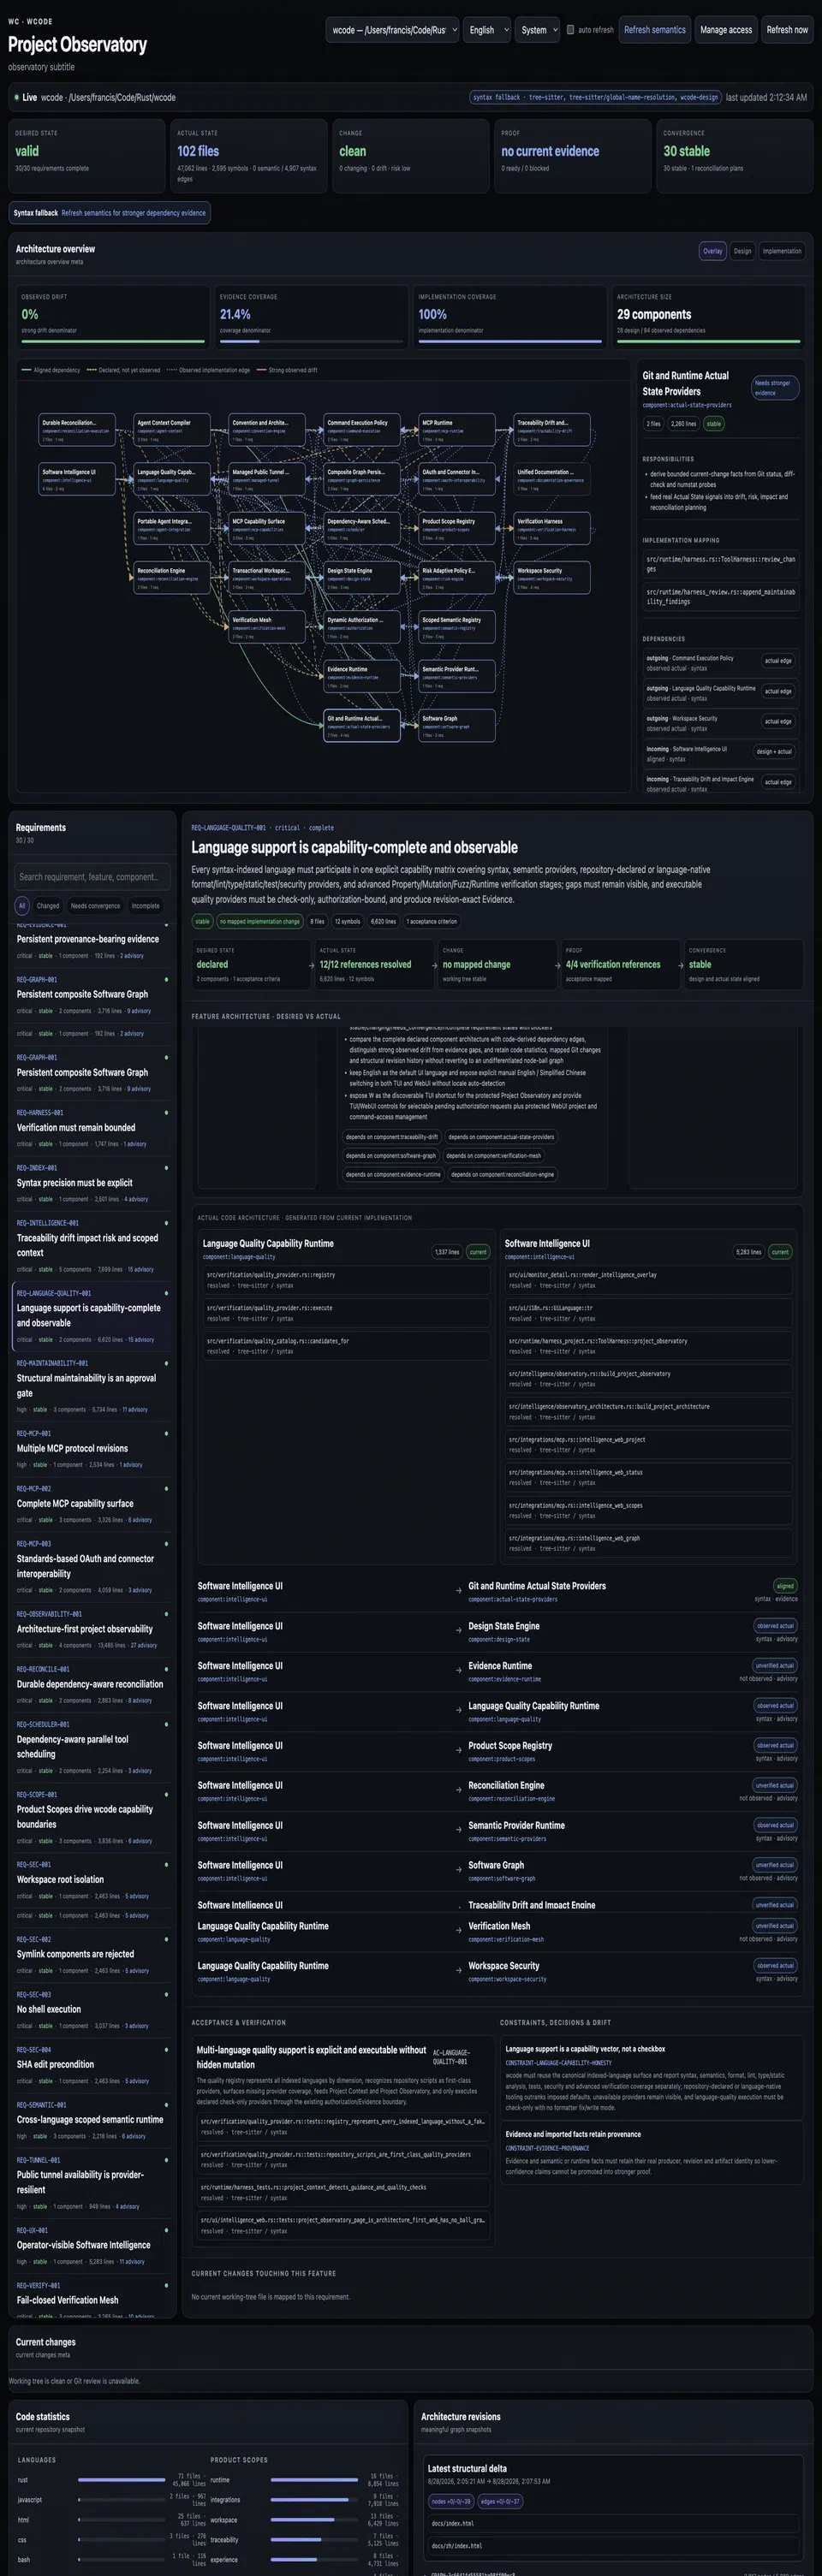
完整页面从架构总览、需求详情、当前变更、代码统计到图快照历史,一图到底:
怎么用#
macOS 和 Linux:
curl -fsSL https://raw.githubusercontent.com/francis-du/wcode/main/install.sh | sh
Windows 有 PowerShell 安装脚本,也可以在源码目录直接构建:
cargo install --path .
进入项目目录后运行:
wcode --workspace "$PWD"
要同时开放多个仓库,就重复 --workspace:
wcode \
  --workspace ~/Code/backend \
  --workspace ~/Code/frontend
启动后,在 AI 客户端中添加终端显示的 https://…/mcp,选择 OAuth,再在授权页输入六位配对码。
只想读代码可以加 --read-only;不允许执行命令可以加 --no-exec;已经有固定反向代理,就使用 --public-url https://your-domain.example。
还没解决的东西#
wcode 现在已经能稳定完成我最初想做的事,但它当然不是终点。
Quick Tunnel 适合零配置,不适合需要固定地址的长期部署;Tree-sitter 是跨语言的语法索引,不是 Language Server;不同 Web 产品对 Remote MCP 和 OAuth Discovery 的支持也一直在变化。即使一个客户端声称支持 Streamable HTTP,也不代表它已经能完整跑通 OAuth。
接下来我会继续补客户端实测、协议兼容、代码索引精度、诊断和安全回归。至于模型和 Agent Loop,我还是不打算做。让 wcode 保持一座小而清楚的桥,比长成另一套平台更有价值。
代码留在本地,AI 客户端自己选。