
wcode v0.6.2:我不再拿 SLOTS 当性能了
本文目录11 个章节
前几天我一直盯着 wcode 的并发面板看。
SLOTS 32,PEAK 看起来也不低,但实际跑起来还是有一种很奇怪的感觉:数字挺忙,任务不一定真快。
我把执行链拆开看了一遍,问题就清楚了。
外层 Tool Slot 只表示请求已经准入。CPU、文件 I/O、cargo、git、Language Server 还有各自的线程池或队列,外面 32 个槽位全亮,并不代表里面 32 份工作都在向前跑。
0.6.2 先把这些资源分开计量和限制。
SLOTS、CPU、I/O、子进程是四件事#
现在我更愿意把执行路径看成:
Tool admission
      ↓
Foreground CPU budget
      ↓
Bounded file I/O pool
      ↓
Child process / Git probe queues
它们有不同的瓶颈。
前台 CPU 工作线程会取硬件并行度、8 个线程、内存推导上限和请求并行度的最小值。阻塞线程池上限提高到 64,是为了不让大量独立阻塞请求被隐藏的较小线程上限卡住。
独立文件修改走共享、有界的 I/O Pool;固定形式的 Git 状态和差异检查走独立 Probe Queue,不再和重型编译器进程抢同一组名额。
默认资源预算下,重型子进程仍然是很小的并发数。因为同时启动 20 个 cargo 不会 magically 变快,只会把机器打爆。
我专门撤回过一个“看起来更并行”的优化#
这轮有一件事我觉得挺重要:我试过把热读取也放进更宽的线程池,结果本地配对实验更慢。
所以撤回了。
做 Agent Runtime 很容易有一种冲动:
线程更多 = 更快
队列更深 = 吞吐更高
并发数更大 = Agent 更强
配对结果不好看就撤回。0.6.2 后面的资源调整也基本按这个标准做:先把不同类型的工作隔开,别靠调大一个统一并发值解决所有问题。
32 个命令排队时,我还希望 Read 能进去#
如果所有 Tool Slot 都被执行进程占满,Agent 连 read_file、状态查询这种轻操作都进不来,系统就会出现另一种死锁感。
所以执行进程类工具在拿总 Tool Slot 前,还要先拿一层 Execution Admission。
总量是 32 时,执行类请求最多占 28 个槽位,给非执行工具留四个受控余量。单槽位配置则保留一个可用名额,不会把自己完全饿死。
它不保证固定延迟,但编译队列再长,read_file 和状态查询至少还有机会进来。
明确的错误位置,不应该先全仓搜索#
性能不只在 Scheduler。
我调真实任务时发现另一个很浪费的路径:模型已经拿到了这种信息:
error[E0308] at src/runtime/harness/context_budget.rs:33:9
结果 agent_context 还先做一遍广域符号检索,再回来读这个明确位置。
这顺序反了。
现在带文件和行号的诊断会先经过 Workspace 保护解析,然后直接保留对应源码原文、行范围和 SHA 编辑前置条件。简单位置查询可以暂缓 Repo Graph 扩展;调用方、Impact、架构或显式 Scope 查询仍然走深入路径。
缺失位置也不会先把一堆无关文件索引起来再告诉我“没找到”。
这类任务现在先吃掉已有的精确位置,只有问题真的需要跨文件关系时才继续扩图。
同一个冷索引也不应该被重复建 10 次#
并发 Agent 很容易同时问同一个文件。
以前多个冷查询可能一起发现“没有索引”,然后各自开始建。
现在同一 Workspace、同一文件的冷查询会共享正在进行的索引构建。不同文件仍然可以独立执行;失效和版本变化会阻止旧构建结果晚到后重新污染缓存。
这里没有做增量 Tree-sitter,也没有引入全仓快照,只是把同一份冷索引的重复构建合掉。
symbol_context 开始对自己返回的版本负责#
另一个一致性问题是:索引说 Symbol 在 A,但真正读正文时文件已经变了。
如果这时还把旧签名和新正文拼成一个结果,Agent 会拿到一个内部自相矛盾的 Context。
现在 symbol_context 会核对符号信息和正文是不是同一文件版本。发现旧索引最多重新获取一次;文件持续变化、拿不到稳定版本时,就明确失败。
我宁愿返回“现在无法稳定读取”,也不想返回一个看起来完整的 Frankenstein Context。
验证计划不能静默只跑前八项#
0.6.2 还修了一个更严重的问题。
混合语言仓库里,完整验证可能推导出十几项检查。旧路径有一处会静默只取前八项。
这类优化最危险的地方不是少跑了几个命令,而是上层可能还把已经执行的前缀描述成“完整验证”。
现在先构造完整计划,整体上限是 32。超限就在派发前失败,明确告诉调用者没有执行检查,而不是偷偷截断。
验证历史也会在一次请求里共享代码 Revision 和 Evidence Snapshot,减少重复扫描;结果要同时匹配 Code 和 Design State 才能展示为当前有效。
窄范围检查不能把宽范围失败抹掉,时间戳冲突按失败关闭。Evidence 缺失或扫描截断,也不能被解释成通过。
verify_project 可以断线以后再查#
项目验证现在还复用了 MCP Tasks 扩展。
客户端支持 Tasks 时,服务端可以先持久化任务并返回 taskId,验证继续由 Runtime 管理。客户端断线后,可以拿同一个 ID 查询状态。
这里我刻意没有加一个模型可见的 async=true 参数,也没有把断线等同于自动重试。
因为对带副作用的系统来说,最危险的一句话就是:
没收到响应,那再执行一遍吧。
完成状态只表示底层工具返回了结果,不等于检查通过;调用者还必须读真正的 passed / error 状态。
配置终于开始收敛#
wcode 可调参数越来越多以后,另一个问题也很明显:高级参数是给调试和特殊机器用的,不应该逼所有人启动时手写一排数字。
所以现在有三档常用性能配置:
balanced
fast
light
也可以先预览:
wcode setup --performance fast --dry-run
wcode --show-config
真的执行 Setup 才会保存审核过的启动选项。
同时新增了:
wcode help-all
wcode help-all setup
wcode help-all --json
它直接从真实 CLI Parser 生成完整命令和参数目录,包括隐藏高级选项、短参数、别名、默认值和枚举值。
普通 --help 继续保持短。我不想为了“可发现性”把日常帮助页重新塞成说明书。
WebUI 首屏也一起收了#
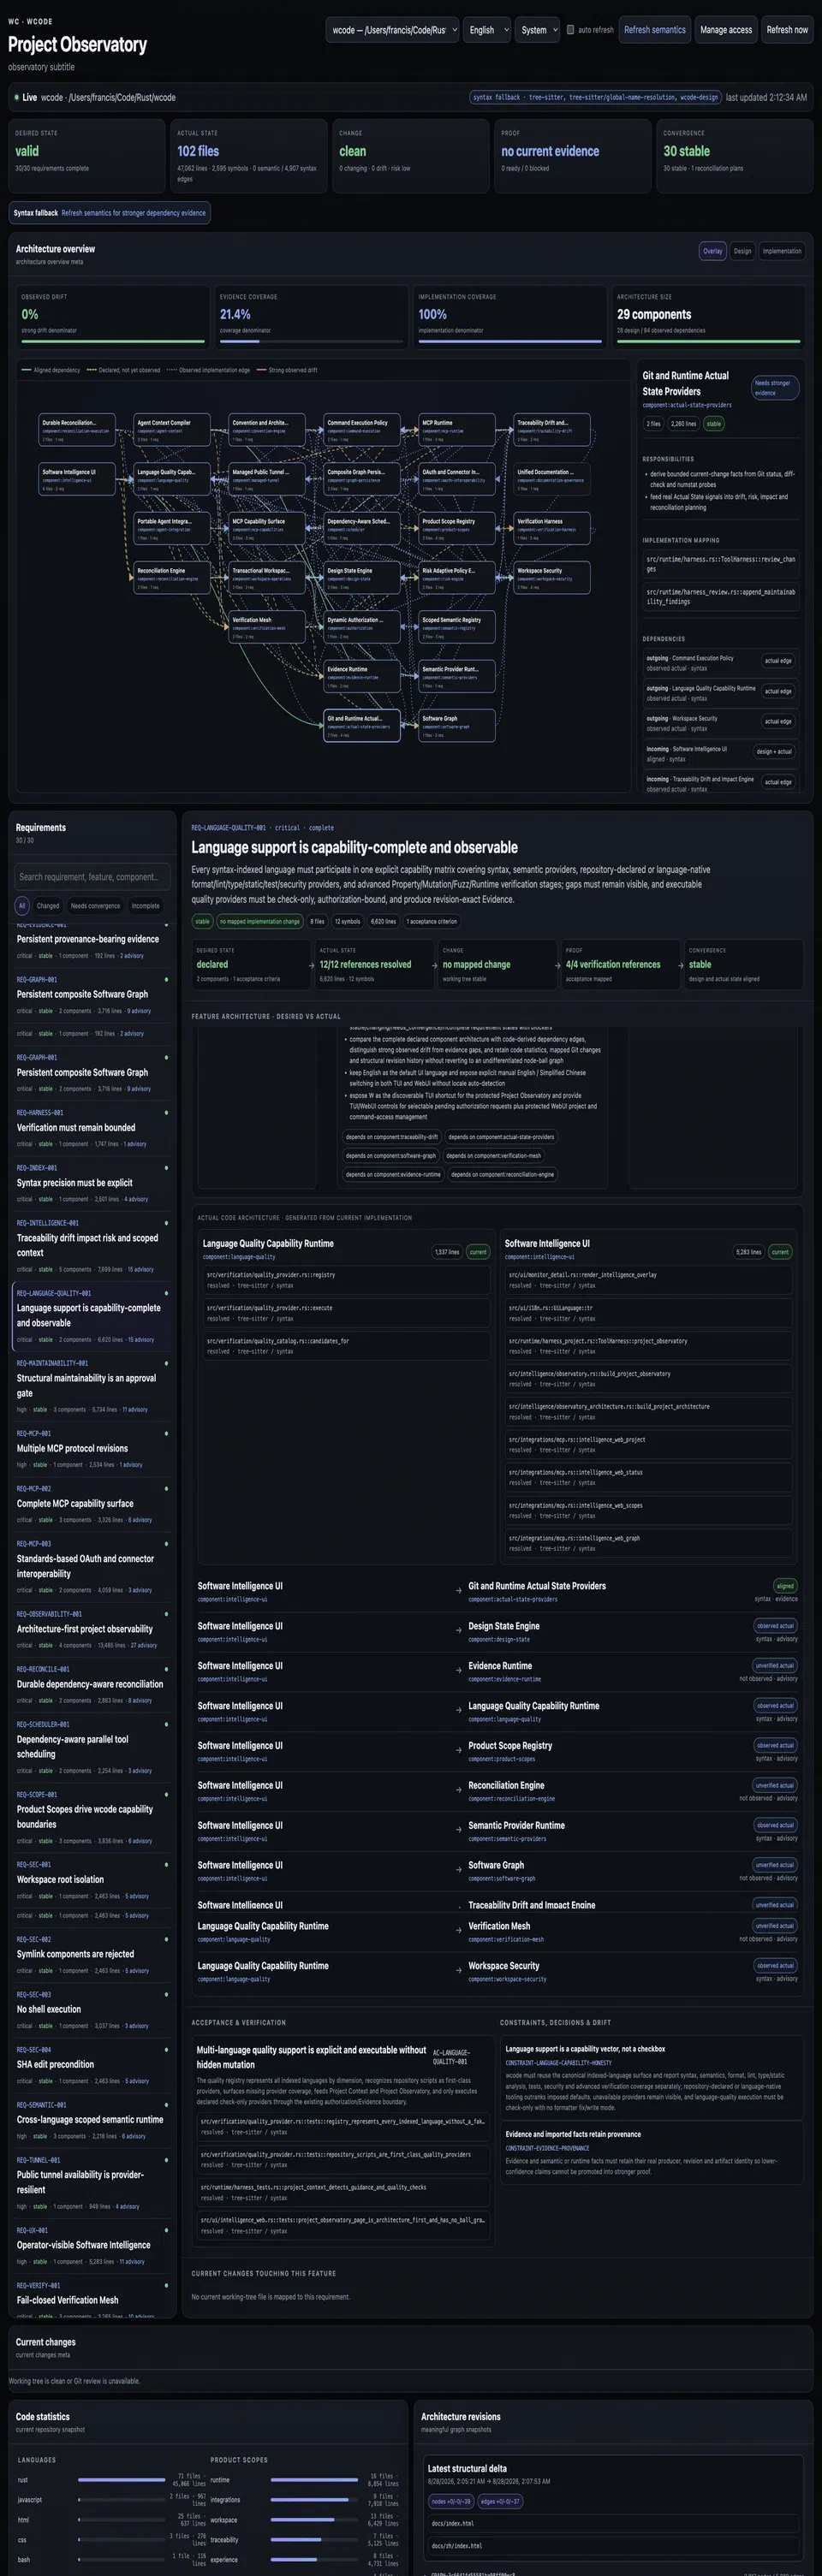
Observatory 这轮主要改首屏信息层级。
现在执行活动、待批准请求、工作树变更、当前有效验证结果分开显示。Architecture 入口改成可搜索组件卡片和详情 Inspector,Design / Implementation / Overlay 图仍然保留,但不再要求用户先读一张很大的图才能知道项目现在发生了什么。
活动刷新也和慢项目刷新拆开。页面隐藏时停止轮询;共享进程资源和当前项目任务分开标记;“没有采样”不再画成“0”。
我主要想避免一件事:没有数据时别画成一个看起来很健康的数字。
做完以后,我给自己留了几条检查项#
我最后给自己留下几条明确的检查项:
- Slot 数不等于吞吐;
- 拿到文件和行号,先读明确位置;
- Verification mapped 和 executed 分开;
- Task completed 和 checks passed 分开;
- 断线不自动重放;
- 没有采样就显示 unknown。
0.6.2 没有一个单独的大功能,更多是在把这些边界钉死。对我来说,这比再加一批 Tool 更实际。