
wcode v0.5:LSP 不再每次现启
本文目录11 个章节
v0.4 做完以后,我以为 wcode 写代码这条主链已经比较顺了。
那一版主要解决 Context 成本:agent_context 变成 Coding Entry,Repo Map 有了 Cache 和 Scope,简单任务不需要每次把整个项目重新理解一遍。
但真的继续拿它写代码,很快又遇到另一个问题。
不是“找不到函数”。
Tree-sitter 和 Search 对定位其实已经很好用了。
真正麻烦的是这种问题:
谁在调用这个函数?
这个 Trait 到底有哪些实现?
改这个 Symbol 会影响哪些跨文件 Reference?
这个调用关系是同名文本,还是类型系统真正解析出来的?
这种时候,grep 能找到很多东西,但不一定完整;Tree-sitter 能告诉我语法结构,但它也不应该假装自己知道类型系统。
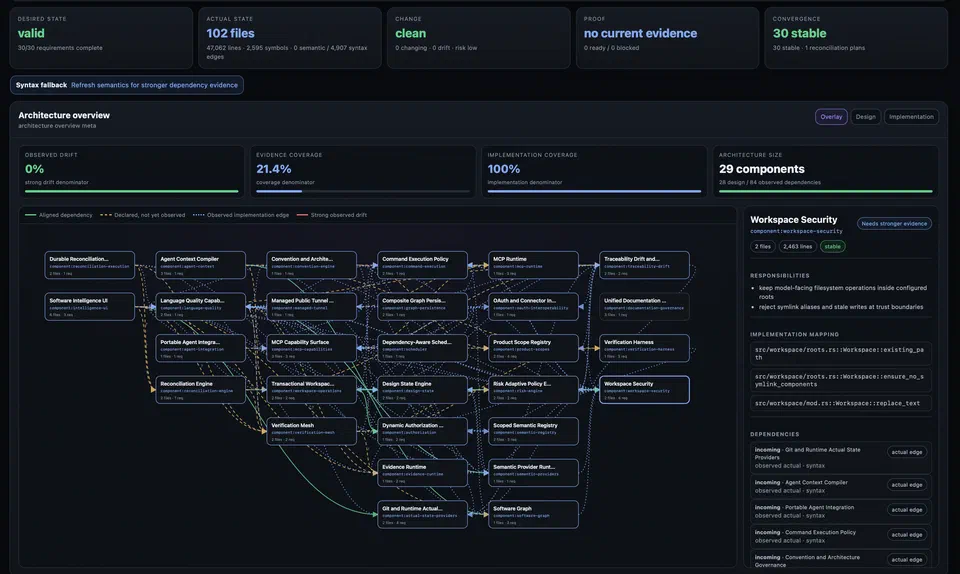
所以 v0.5 没继续堆零散的 LSP API,我直接把 Language Server 的生命周期重新做了一遍,让它可以受限地常驻和复用。
我为什么没有把所有查询都切到 LSP#
最直接的做法其实很诱人:
既然 Language Server 更懂代码,那以后 Definition、Search、Reference、Call 全走 LSP 不就好了?
我试着沿这个方向想了一轮,最后放弃了。
原因是 Agent Coding 里有两类完全不同的问题。
第一类只是定位:
这个函数在哪?
这个 Struct 定义在哪?
哪个文件包含这个字符串?
这类问题 Tree-sitter / Search 很便宜,而且稳定,不需要启动项目语义环境。
第二类才是真正需要 Semantic Completeness 的关系问题:
references
implementations
incoming callers
outgoing callees
rename impact
如果为了第一类问题也默认走 Language Server,就会把一个本来很便宜的定位动作变成进程启动、Initialize、Document Sync、Semantic Query。
而 Agent 还有一个额外成本:Tool Result 最后会进入 Context。
所以我现在更愿意把两层能力分开:
                ┌──────────────────────┐
                │     agent_context     │
                └──────────┬───────────┘
                           │
                普通定位   │   跨文件关系
                           │
          ┌────────────────┴───────────────┐
          ↓                                ↓
find_symbol / search_code          semantic_navigation
Tree-sitter / text search                 │
          │                               ↓
          │                       Warm LSP Session
          └──────────────┬────────────────┘
                         ↓
                    edit / review
                         ↓
                    verify_project
不是“LSP 比 grep 高级,所以替掉 grep”。
而是让每一层只解决它真正擅长的问题。
以前的 LSP 其实还是一次性工具#
wcode 之前已经能跑 Language Server。
但生命周期很像一个 Batch Job:
start provider
  ↓
initialize
  ↓
didOpen
  ↓
Document Symbol
Call Hierarchy
Implementation
  ↓
shutdown
它适合定期补 Software Graph。
但如果 Agent 紧接着又问一次 Reference,就要重新付一遍启动成本。
更关键的是,这种模型下“Semantic Provider”在架构上仍然只是一个索引器,不是真正的 Runtime。
v0.5 把这个生命周期改了。
现在 Harness 里有一个有界 Session Pool:
Workspace
   ↓
Provider + Binary Identity
   ↓
Warm Session Slot
   ├── graph refresh
   ├── semantic_navigation
   ├── didChange
   └── didClose
同一个 Workspace 下,后台 Graph Indexing 和前台 Navigation 会复用同一个 Provider Process。
如果 rust-analyzer 已经 Warm,第二次查 Caller 不需要再启动一遍。
Warm 不等于永远不关#
我不想为了省启动成本,最后在后台养一堆永远不会退出的 Language Server。
所以这个 Pool 从一开始就是 Bounded 的。
它有几条约束:
- Session 数量有上限;
- Idle Slot 会淘汰;
- 同一个 Slot 的 JSON-RPC Stream 串行处理;
- Provider Process 死掉以后重建;
- Provider Binary Identity 变了以后重建;
- Workspace Key 不共享到别的项目;
- 离开当前有界索引集合的 Document 会
didClose。
发版前我专门沿这条生命周期又审了一遍,结果真的抓到一个边界 Bug:最初的 Idle Eviction 其实是 Lazy 的,只有下一次有人访问 Session Pool 时才会 Prune;更糟一点,容量满时如果直接从 Map 里移除“最旧 Slot”,这个 Slot 可能还被一个 Active Request 持有,于是 Map 看起来仍然只有 16 个,实际进程却可能短暂跑到第 17 个。
最后我把规则改成了更保守的版本:
Idle + unleased
  → 可以 prune

capacity full + 有 unleased slot
  → 只驱逐 unleased slot

capacity full + 全部 leased
  → fail closed / retry

provider binary changed + old slot still leased
  → 等当前 request 结束
  → 再替换
Background Semantic Coordinator 也会周期性主动 Prune,所以即使是没有 TUI 交互的 mcp-stdio,Idle Bound 也不是一句文档里的承诺。
源码变化也不是简单把 Process 杀掉重启。
现在不是强行给所有 Server 发同一种 Notification,而是先看它在 initialize 里声明的 textDocumentSync:
Full
  → Open 发完整内容
  → Change 发整文档

Incremental
  → Open 发完整内容
  → Change 用旧文档范围做合法 replacement
  → Range 按协商的 UTF-8 / UTF-16 / UTF-32 算

None / openClose=false
  → 不硬发 Server 没声明支持的 Notification
  → Server 继续从磁盘读取
只有 Server 要求 Open/Close Sync 时才发 didOpen / didClose。这才比较像我理解的“常驻语义层”:它既知道当前 Document Revision,也尊重每个 Language Server 自己的同步协议,而不是假定 Rust 能工作的 Change Shape 对 22 种语言都成立。
semantic_navigation 不让 Agent 自己算 UTF-16#
做 Agent Tool 时,我越来越不喜欢把底层协议细节原样扔给模型。
原始 LSP 通常希望调用方给:
file URI
line
character
position encoding
然后不同 Server 还可能用 UTF-8 / UTF-16 Position Encoding。
让模型自己根据源码去算 UTF-16 Offset,我觉得完全是在浪费模型能力,而且很容易在非 ASCII 代码里漂掉。
所以 v0.5 的 semantic_navigation 主入口是:
path + symbol
wcode 自己先用 Tree-sitter 找 Symbol 的精确位置,再根据 Language Server Initialize 时协商到的 Encoding 转换 Position。
Agent 只需要表达意图:
definition
hover
references
incoming_calls
outgoing_calls
implementations
impact
真正已经持有精确 Position 的调用方,也可以继续传 line + character。
这件事看起来很小,但我觉得它代表一个方向:
LSP Primitive 不应该直接等于 Agent Primitive。
Agent Tool 应该封装成模型真正想问的问题,而不是要求模型先学会协议的坐标系。
这里发版审计又抓到另一个我不愿意留到 0.5.1 的问题:最早实现里,如果 Server 声明支持 references,但这次 Request 实际 Timeout / Error,结果路径可能最后只留下一个空数组。对 Agent 来说,“请求失败”和“确实没有 Reference”完全不是一件事。
所以现在 Result 会明确分成:
unsupported
  → Server 没这个能力

failures
  → Server 有能力,但这次 LSP Request 失败

relationships = []
  → Request 成功,真的没有匹配关系
我尤其不想让失败被当成 Negative Semantic Evidence。语义系统最危险的不是“不知道”,而是失败以后还表现得像自己很确定。
22 种语言,不能只有 Rust 真正跑得通#
发版前我又给这版加了一条更苛刻的要求:
既然 wcode 对外说 Syntax Index 支持 22 种语言,那 LSP 层也不能只把 rust-analyzer 做扎实,其他语言只在 Registry 里挂个名字。
这次审计以后,我把“支持”拆成了三个完全不同的概念:
Compatibility
  → wcode 有没有正确的 Provider Adapter / Command / Language ID

Installation
  → 用户机器上有没有真的装这个 Language Server

Live Semantic
  → 这个已安装 Server 有没有真实 initialize 并回答当前 Revision
只有第一层是 wcode 在 Build/Test 阶段能 100% 保证的。
第二层取决于用户机器。
第三层必须等 Runtime 真正和 Server 完成 LSP Handshake 以后才能成立。
所以 v0.5 现在要求 22 种 Indexed Language 每一种恰好只有一个 Canonical LSP Launch Profile,并用测试把映射和 Provider-specific Argument 锁死。除此之外,我还加了一层跨平台 stdio Mock LSP:每一个 Canonical Profile 都会真的 Spawn 一个子进程,完成 initialize、Capability Negotiation、Open/Change/Close 和 Hover JSON-RPC 往返,而不是只检查数组里的字符串:
| Language | Canonical LSP |
|---|---|
| Bash | bash-language-server start |
| C / C++ | clangd |
| C# | csharp-ls |
| CSS | vscode-css-language-server --stdio |
| Dart | dart language-server --protocol=lsp |
| Elixir | ElixirLS language_server.sh / Wrapper |
| Go | gopls serve |
| HTML | vscode-html-language-server --stdio |
| Java | jdtls -data <unique state> |
| JavaScript / TypeScript / TSX | typescript-language-server --stdio |
| Lua | lua-language-server |
| OCaml / Interface | ocamllsp |
| PHP | phpactor language-server |
| Python | pyright-langserver --stdio |
| R | R --no-echo -e languageserver::run() |
| Ruby | ruby-lsp |
| Rust | rust-analyzer |
| Swift | sourcekit-lsp |
而且这次不是把旧 Registry 原样拿来写测试。
我对着各家的当前启动方式重新过了一遍,确实发现了几个容易变成“纸面支持”的地方:
- Go 明确改成
gopls serve; - JDT LS 会拿一个 Workspace + Runtime 唯一的用户级
-data目录,避免两个项目或两个 wcode Process 共用 JDT State; - Dart 使用
dart language-server --protocol=lsp,并带上 wcode 的 Client ID / Version; - Elixir 同时识别官方
language_server.sh、Windows Wrapper 和常见发行版elixir-ls; - LuaLS 对 Symlink 启动比较特殊,所以不能照抄 rustup Proxy 的处理方式,发现 Symlink 时会执行 Canonical Target;
- OmniSharp 的
-lsp不再被拿来凑 C# Fallback 数量,C# Canonical 路径只认csharp-ls。
真正有意义的 Alternate 只留了三个:
PHP     phpactor → intelephense
Python  pyright  → pylsp
Ruby    ruby-lsp → solargraph
更重要的是,Fallback 不是只存在配置表里。
现在 semantic_navigation 和手工 semantic_provider_refresh 都会在:
canonical executable exists
        ↓
initialize fails
        ↓
try installed alternate
但 Alternate 不会继承 Canonical Provider 的授权。
如果它属于非 Automatic Provider,就必须拿自己的 Workspace + Provider + Binary Identity Trust;Refresh 成功切换以后,结果里还会显式记录 fallbacks。
所以这里我想表达的不是“wcode 自带 22 个 Language Server”。
它当然没有。
而是:22/22 的 Adapter Contract、stdio Framing 和 Provider-specific Launch Profile 是 wcode 自己要负责的;External Server 是否安装要诚实报告;Semantic Precision 只有那份真实 Binary Live Initialize + 当前 Revision Response 以后才成立。
这比在 README 里写一个长长的“Supported Languages”列表可靠得多。
默认开启以后,安全边界反而要更严格#
这次另一个比较大的决定,是 Hardened Semantic 默认开启。
也就是说普通启动:
wcode --workspace "$PWD"
如果项目里有 Rust,而且系统里有可用的 rust-analyzer,wcode 会自动维护这条 Semantic Lane。
但我没有把“所有 LSP 默认信任”一起打开。
v0.5 当前只有 rust-analyzer 进入 Automatic Profile。
因为 Language Server 和普通 Parser 不一样:它会读项目配置,有些 Server 甚至可能间接执行 Repository-controlled Code。
所以默认 Profile 做了几层限制:
- Executable 必须解析到 Workspace 外;
- Workspace 里的假
rust-analyzer不会被执行; - Credential 和 Execution-injection Environment Variable 会清理;
- Build Script 关闭;
- Proc Macro 关闭;
- Cargo Auto Reload 关闭;
- Check-on-save 关闭;
- Result 最后仍重新经过 Workspace Boundary Filter。
这不是 OS Sandbox。
我不想用“安全模式”这种词让人误以为 Language Server 完全没有执行面。
它只是一个我愿意默认打开的、被明显收窄过的 Profile。
如果是 clangd、Pyright、gopls 或其他当前还没有 Hardened Profile 的 Provider,仍然需要显式 RiskyExecution Trust。
而且 Warm Session 出现以后,授权语义也跟着变了。
以前一次性 Provider 可以按某次 Refresh Operation 授权。
现在 Process 会被复用,真正准确的 Trust 应该是:
Workspace
  + Provider
  + current Provider Binary Identity
这个 Binary Identity 也不能漏。发版审计时我发现,第一版 Provider-session Fingerprint 只绑定了 Provider ID;如果 PATH 上同名 Provider Binary 被替换,Session Key 会重建,但旧授权理论上仍可能继续适用。现在 Authorization 和 Warm Session 使用同一套 Provider Binary Identity:Executable 被替换以后,旧 Grant 不会继承过去。
因此同一份已批准 Provider 可以被 Refresh 和 Navigation 复用,不会每问一次 Reference 又弹一次权限;但它也不会顺手授权替换后的 Binary。
如果完全不希望 wcode 启动第一方 Language Server:
wcode --workspace "$PWD" --no-semantic
Tree-sitter / Search 仍然都在。
后台自动维护也不能绕过全局资源边界#
另一个我不想接受的状态是:
前台 Tool 都有 Global Semaphore,后台 Semantic Worker 却偷偷无限跑。
那 TUI 上看到的并发数就会是假的。
所以 Background Semantic Maintainer 也必须先拿 Harness Permit,再真正进入 Running。
生命周期还是:
queued
  ↓
acquire global permit
  ↓
running
  ↓
completed / failed
Broad Workspace 下面如果还有具体 Project Subspace,也只让最具体的 Leaf Workspace 启动自动 Semantic Worker。
不然我把 ~/Code 暴露给 wcode 时,父目录和十几个子项目会同时索引同一批源码。
这种优化不会出现在“支持哪些 LSP”的 Feature List 里,但我觉得比多支持一个 Server 更重要。
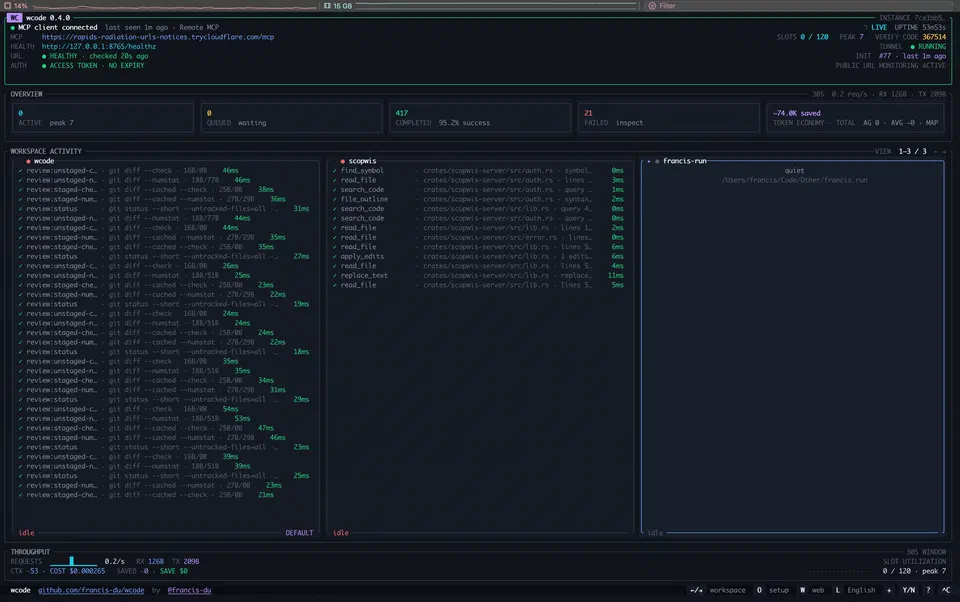
TUI 现在能看出 Warm 到底有没有生效#
以前 TUI 的 LSP 状态主要是:
available / runnable
fresh / stale
v0.5 现在还会显示:
warm sessions
synced documents
provider starts
semantic queries
我特意加这些,不是为了让 Dashboard 再多几个数字。
而是 Warm Runtime 最容易出现一种假优化:代码里写了 Cache,但实际上每次 Query 还是重启 Process。
如果 Session Start 一直涨、Query 也一直涨,那我就知道复用没有真的工作。
可观测性是性能优化的一部分,不是最后补的 UI。
v0.4 和 v0.5 的差别#
如果 v0.4 是“让 Intelligence 不要变成 Context Tax”,v0.5 更像是“让语义能力真正进入日常 Coding Hot Path”。
| v0.4 | v0.5 | |
|---|---|---|
| Semantic Provider | 有界 Batch Refresh | Bounded Warm Runtime |
| LSP Process | Refresh 后退出 | Workspace Session 复用 |
| Document Sync | didOpen 为主 |
Server-declared Full / Incremental / None |
| Agent Navigation | Syntax + Graph Context | semantic_navigation |
| Default Routing | agent_context + Tree-sitter |
Localization 走 Syntax,Relationship 才走 LSP |
| Automatic Trust | LSP 需要显式 Trust | Hardened rust-analyzer 默认开启 |
| Non-auto LSP | Exact Refresh Trust | Workspace + Provider Session RiskyExecution |
| TUI | available / fresh | available → launch-ready → live + warm/fresh |
我觉得这已经不是 0.4.x 的 Patch。
所以版本直接到了 v0.5.0。
这次发版我也把 Release Boundary 再收紧了一次#
Milestone Release 最怕的不是功能没写完,而是“仓库里的版本看起来有六个答案”。
wcode 现在除了 Cargo Version,还有 Agent Plugin / Marketplace Manifest。
v0.5 发版前我把它们统一成同一个版本,并且不只依赖 CI Shell Script 检查。
Unit Test 也会验证:
Cargo package version
  == plugin.json
  == Claude plugin
  == Codex plugin
  == ZCode plugin
  == root marketplace
  == plugin marketplace
Release Workflow 还会再独立检查一次,然后跑:
Design / Traceability / Product Scope gate
Format
Check
Clippy --all-targets
Linux test
macOS test
Windows test
Linux / macOS / Windows release build
binary --version
SHA256SUMS
这次 Tag 前最后一轮本地 Full Gate 是:
git diff --check                       ✅
cargo check --locked                   ✅
cargo fmt --check                      ✅
cargo test --locked                    ✅ 270 passed / 0 failed
cargo clippy --locked -- -D warnings   ✅
cargo build --release --locked         ✅
这里的 270 个核心测试已经包含 22 个 Canonical Profile 的真实 stdio Mock-LSP Initialize Contract、Full/Incremental/None Document Sync、Warm Session Capacity/Idle、Provider Binary Trust、Fallback 和 Navigation Failure Semantics。
我仍然不想把“本机 cargo test 绿了”直接等同于“Release 已经成立”。
真正发布的是 Tagged Revision 和对应 Artifact;Linux/macOS/Windows 的最终跨平台结论继续交给 Tag CI。
最后#
wcode 最开始只是我为了让 Web AI 安全碰本地代码写的一层 MCP Bridge。
后来它慢慢有了 Design State、Software Graph、Verification、Evidence、Reconciliation。
v0.4 我开始对 Agent 的 Context 成本负责。
到 v0.5,我又多了一层判断:
代码智能不应该只有“便宜但不完整”和“准确但每次很重”两个极端。
Tree-sitter / Search 可以一直做便宜、稳定的定位底座。
Language Server 则应该在真正需要关系完整性的地方,以受限、可复用、可观测的 Runtime 形式出现。
不是把所有东西都升级成 LSP。
而是让 Agent 知道:什么时候 Syntax 已经够了,什么时候值得支付 Semantic Cost。
这应该会是后面 wcode Semantic Runtime 继续扩展其他语言时最重要的一条原则。
代码:https://github.com/francis-du/wcode
v0.5.0 Release Notes:https://wcode.francis.run/docs/releases/v0.5.0/