
Codex、Claude Code、ZCode、Kimi Code:我是怎么搭配 wcode 用的
本文目录17 个章节
这半年我轮着用了 Codex、Claude Code、ZCode 和 Kimi Code。几个工具各有顺手的地方,但我最烦的事一直没变:换个客户端,项目背景又要重新讲;任务做长了以后,最后那句 tests passed 到底对应哪个版本,也经常说不清。
所以这篇我不想排一个“谁最强”的总榜。我更关心两件事:Agent 本身怎么执行任务,以及仓库里哪些状态不应该跟着聊天会话一起丢。
wcode 放在第二层。它不替代 Codex、Claude Code、ZCode 或 Kimi Code,主要管本地仓库这边的上下文、权限、影响分析、验证和证据。模型和客户端可以换,仓库层的规则尽量别跟着换。
本文比较的是 2026 年 9 月 3 日能从官方文档确认的产品形态,加上我的工程取向,不是一次受控 benchmark。套餐、模型和功能迭代很快,价格与额度请以各家实时页面为准。
我为什么在 Agent 下面再放一层 wcode#
我自己用 Agent 时,真正反复出问题的地方都在执行链上:定位漏文件、拿旧上下文改新代码、只跑了一小部分测试却把整项任务说成完成、换个会话以后又重新猜项目背景。
wcode 现在大致把任务走成这样:
Requirement / Constraint / Acceptance
                  │
          task-ready context
                  ▼
       Software Graph + Git change
                  │
          Impact + Risk analysis
                  ▼
             guarded edit
                  │
       risk-adaptive Verification
                  │
     Evidence + independent review
                  ▼
       Reconciliation / merge decision
我平时最常用的是 agent_context。它会把目标文件、相关约束、当前 SHA、Design State、语义能力状态和验证入口一起给出来,省掉 Agent 开头那几轮全仓摸索。
写入时,文件版本本身就是前置条件。模型读到 A,我手工改成 B,它再拿 A 回来写会直接失败。Workspace、Symlink、受保护路径和命令权限也在同一层处理,不靠某个客户端的 Prompt 记住。
验证则根据项目和改动推导实际检查,并把结果和 code/design revision 绑定。高风险任务可以继续加 Reviewer、Property、Mutation、Fuzz 或 Human Approval,但没跑的东西不会在界面上显示成已经通过。
工具契约我也一直在压缩。默认值和低频调参不需要每次塞给模型,批量读写能一次做完就少一次 MCP 往返。
下面是我现在自己看的 Project Observatory。顶部把 Desired State、Actual State、Change、Proof、Convergence 放在一条链上;组件声明关系和源码里观察到的关系分开显示,Requirement 可以继续钻到实现、验收和证据。
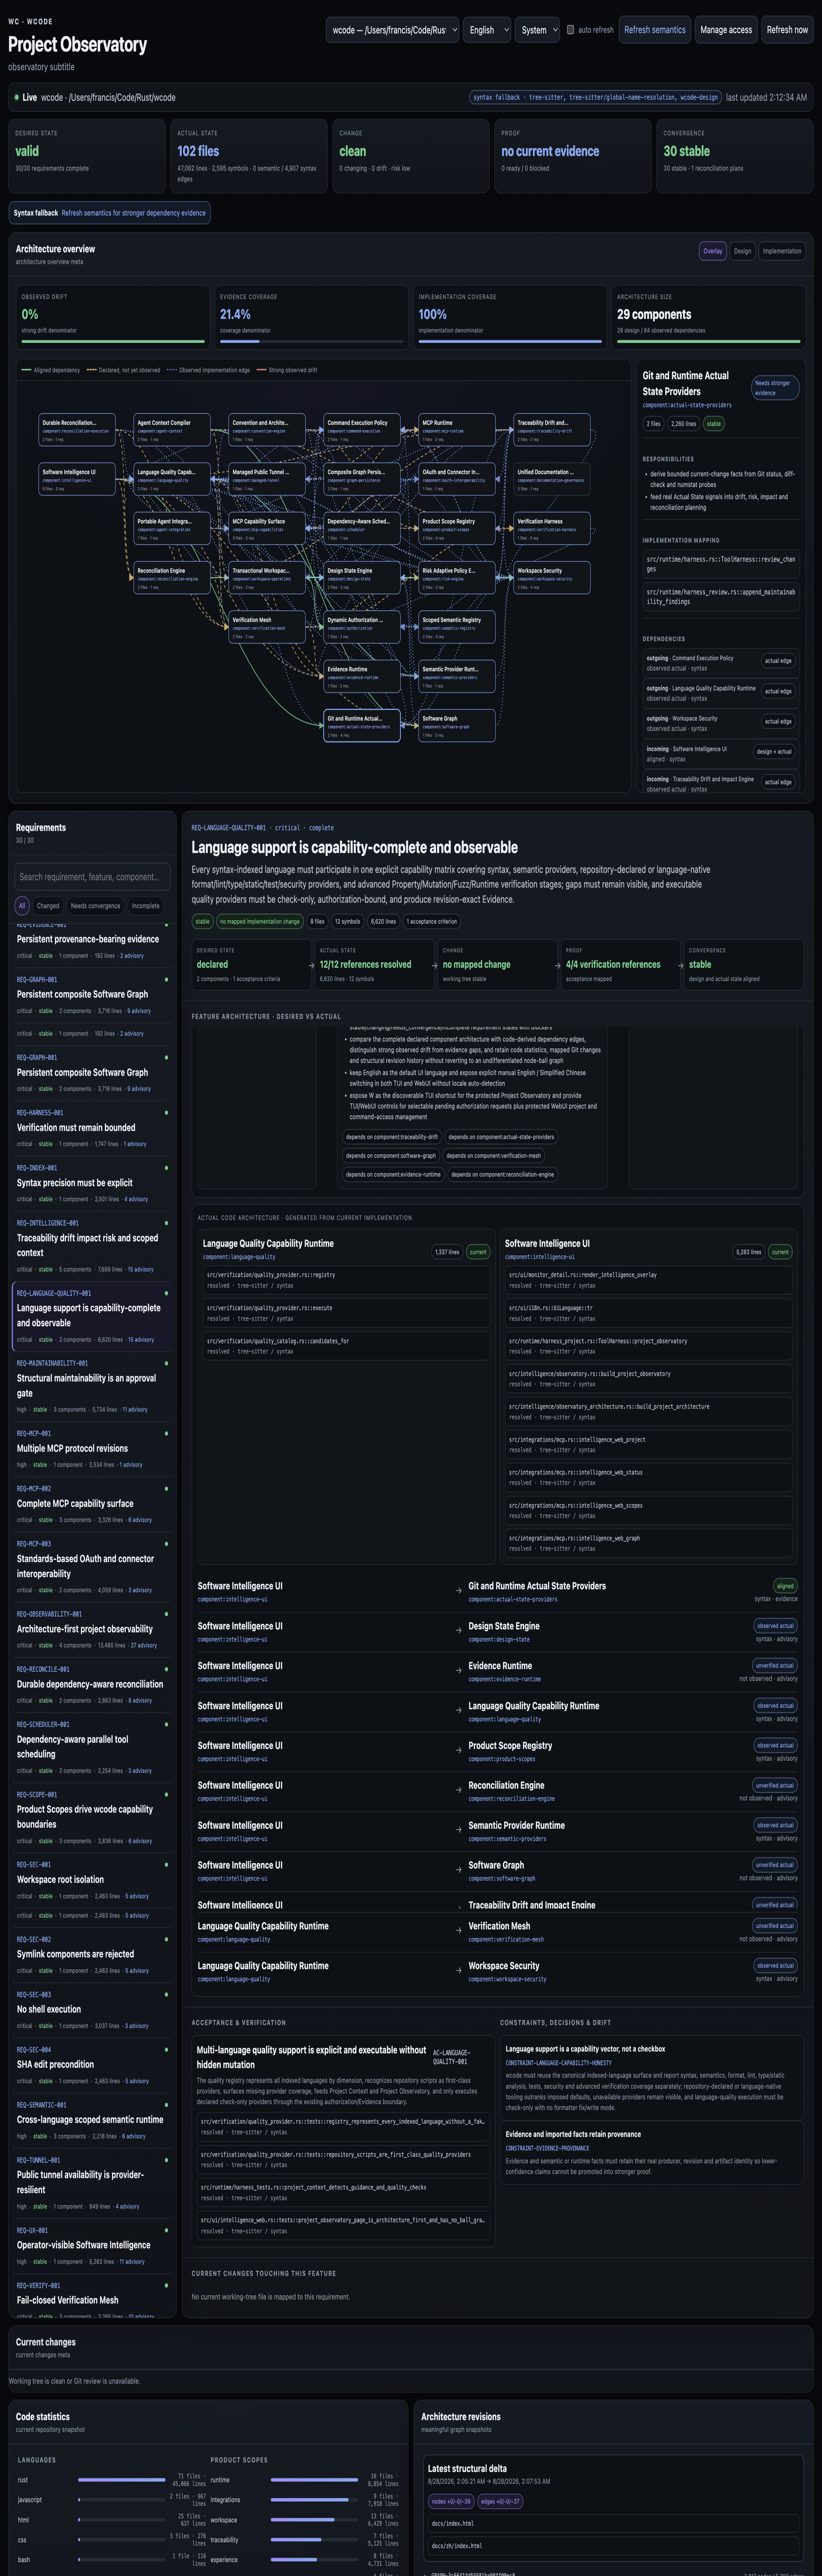
我看 Graph 主要是为了找声明关系和实际关系有没有分叉。两边对不上时,差异会留下来,后面可以继续查,不需要靠某次会话记住。
公开文档里,我没有找到这些闭环的直接对应物#
这里必须把话说准确:我只能比较截至本文日期各家公开官方文档已经展示的能力,不能证明它们内部没有类似系统。下面的“没有”指的是:我没有在 Codex、Claude Code、ZCode、Kimi Code 的公开产品文档中找到与 wcode 等价、面向任意客户端开放、并贯穿整个闭环的内建能力。
| wcode 已实现的能力 | 它具体做什么 | 四款 Agent 文档中最接近的能力 | 关键差异 |
|---|---|---|---|
| 结构化 Design State | 用稳定 ID 保存 Requirement、Constraint、Component、Acceptance、Decision 及其关系 | AGENTS.md、CLAUDE.md、Skills、Rules、项目记忆 |
文本指令告诉 Agent“应该怎么做”;Design State 能被机器校验、查询、追踪覆盖率并关联实现与验收 |
| 多来源 Software Graph | 合并 Tree-sitter、LSP 等来源,保存 provider、precision、源码哈希、历史 revision 和结构 diff | 代码库搜索、符号导航、长上下文、项目索引 | Agent 能找到代码;wcode 还记录关系从哪里来、精度多高、是否因源码变化而 stale |
| Task-ready 上下文与持久工作清单 | 仓库替 Agent 算好改动就绪度、下一步动作和并行机会;跨会话的工作清单持久保存,未完成项不能被悄悄删掉 | Plan、Todo、Goal Mode、任务恢复 | 别人的计划是模型写给自己的备忘,会话结束就蒸发;wcode 的就绪度是仓库算出来的事实,换了模型也能从断点接着做 |
| 风险自适应 Verification Plan | 根据真实 diff、影响范围、设计风险和结构信号决定验证深度 | Agent 自动跑测试、CI、Hooks、Review 命令 | 普通 Agent 决定“要不要跑测试”;wcode 把风险映射到固定阶段、目标和 readiness gate,证据必须声明覆盖对象,一个对象的通过清不掉另一个对象的门禁 |
| 盲审且不互相覆盖的 Reviewer Evidence | Correctness、Security、Architecture、Maintainability 等 reviewer 独立领取任务,一个 Pass 不会覆盖另一个 Fail;规格不清只能给不确定,判失败必须附反例 | Subagents、Agent Teams、多 Agent 并行 | 并行 Agent 侧重分工;wcode 还约束独立首轮、保存 producer 与 verdict,并显式呈现 disagreement |
| Revision-exact Evidence | 确定性检查和 reviewer 结论绑定 workspace、Git revision、producer、artifact 与 confidence | 会话日志、测试输出、任务摘要、PR diff | 日志证明“当时运行过”;wcode 判断证据是否仍匹配当前源码,不匹配就失效或标记 stale |
| Design / Actual Reconciliation | 对比 Desired State、代码图与 Git Actual State,把漂移变成持久计划 | Plan、Todo、Goal Mode、任务恢复 | Agent 计划服务于完成当前任务;Reconciliation 服务于长期收敛设计与实现 |
| 为模型收敛的工具契约 | 模型可见的工具面裁掉默认值与调优噪声,工具标注只读/破坏性语义,并提供批量读写原语 | 各家固定不变的 tool schema | Agent 的工具接口也是上下文税;wcode 把“模型需要看见什么”当成一等工程问题 |
| 客户端无关的仓库安全边界 | 同一套 Workspace containment、SHA 前置条件、no-shell、受保护路径、精确操作授权供不同 MCP 客户端复用 | 各产品自己的 sandbox、permission mode、命令确认 | Agent 权限通常属于当前客户端;wcode 的约束属于仓库工具层,换客户端后仍然成立 |
我在意的不是功能项数量,而是这些状态能不能接起来:
结构化需求
  → 更准确的上下文
  → 更完整的影响分析
  → 与风险匹配的验证
  → revision-exact Evidence
  → 可执行的 Reconciliation
拿一个登录改动举例#
想象一个很普通的需求:“给认证流程增加一种登录方式”。
普通 Agent 会搜索 login,修改几个命中文件,补测试,然后告诉你完成了。运气好,一次通过;运气不好,它漏掉 OAuth callback、配置文档、旧客户端兼容和一条安全约束。问题不是模型不会写代码,而是它不知道哪些遗漏必须被阻止。
接入 wcode 后,Agent 可以先得到这个 Requirement 对应的 Component、Constraint、Acceptance、实际代码关系和当前 Git 状态,还有一份就绪度清单:哪些文件可以改、验证还缺什么、下一步做什么。修改完成后,Impact Analysis 会暴露被波及的模块,Risk 决定验证深度,Verification Plan 固定需要覆盖的目标,Reviewer 独立检查正确性、安全与结构,Evidence 最后绑定当前 revision。
还有两件普通 Agent 给不了的事。任务中途被打断——会话超时、切换模型、换客户端——持久工作清单会把未完成项连同前提一起交给下一个执行者,断点续做,没做完的事不能被悄悄删掉。而如果证据表明这只是个小改动,wcode 会把新抽象、新配置、新公共接口的额度压到零,防止“顺手重构”把加一种登录方式扩成半个认证系统。
Requirement 详情会把 Graph 收敛成可执行视图:Desired State → Actual State → Change → Proof → Convergence。下面这张真实界面里,验证约束、实现组件、语法级实际关系和验收引用同时出现;syntax / advisory 也被明确标注,没有把 Tree-sitter 关系吹成完整语义证明。
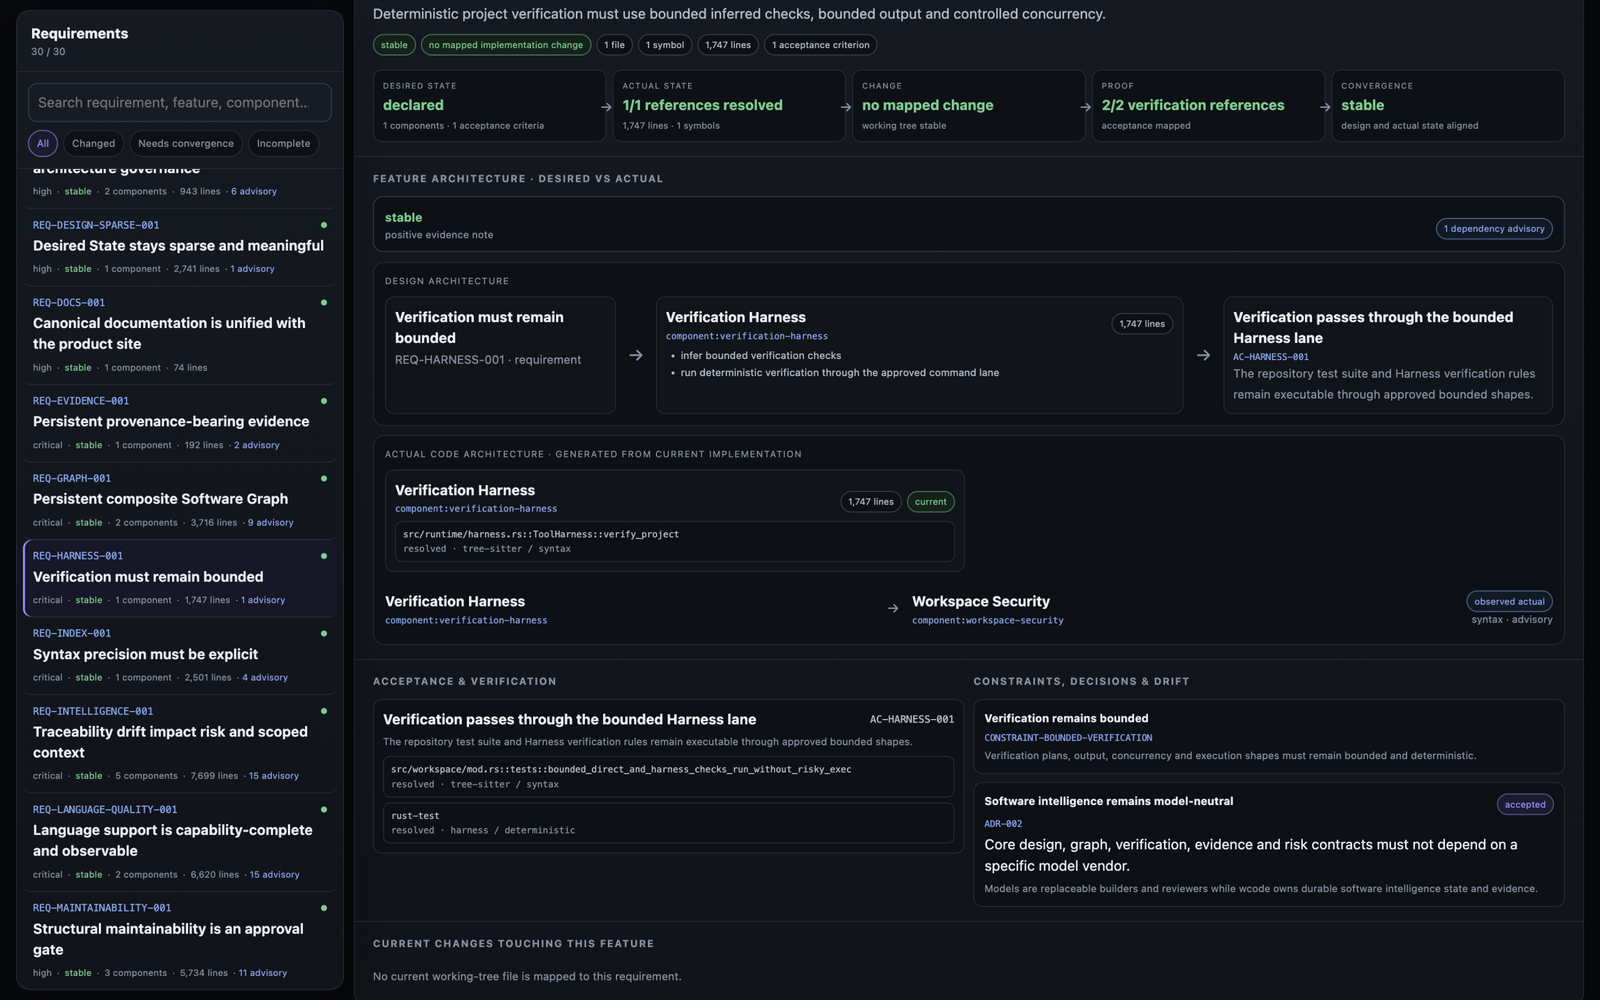
对我来说,wcode 的作用就是把这些容易漏的步骤固定在仓库层。Codex、Claude Code、ZCode、Kimi Code 继续负责各自擅长的执行方式,我不用为了换 Agent 再重新设计一遍权限和验证。
边界也很明确:wcode 不能替代好模型,不能证明所有 bug 都会被发现,也不会把 Tree-sitter 的语法关系说成完整语义。缺 Provider、缺测试、缺 Evidence 时就把缺口留出来。
我会把 Agent 和仓库层分开选#
大多数横评把模型能力、客户端体验和工程治理揉成一个总分,我觉得这会误导选择。
第一条轴是 Agent 执行面:谁理解需求、调用工具、修改文件、运行测试并把任务做完。Codex、Claude Code、ZCode 和 Kimi Code 都在这条轴上竞争,各自选择了不同的终端、IDE、桌面与云端组合。
第二条轴是 Repository Control Plane:需求为什么存在、哪些组件实现它、当前 diff 影响什么、什么风险需要哪一级验证、测试证据属于哪个 revision、设计与代码是否漂移。这是 wcode 的位置。
              负责思考与执行
  Codex · Claude Code · ZCode · Kimi Code
                       │
              tools / MCP / stdio
                       ▼
     wcode:仓库状态、边界、风险与证据
                       │
                       ▼
                 Git repository
所以我不会在这四个 Agent 和 wcode 之间做单选。前者选一个顺手的执行面,后者只在需要长期保存仓库状态时放在下面。
四个 Agent 我怎么选#
四款产品看起来都在“写代码”,实际出发点并不一样。
| 工具 | 更像什么 | 最突出的优点 | 主要代价 |
|---|---|---|---|
| Codex | 横跨 CLI、IDE、桌面和云端的工程 Agent | 本地执行、隔离权限、代码审查、子 Agent、云端并行和结果回收形成完整闭环 | 产品面很宽,功能与账户层级变化快;复杂团队接入仍要认真配置环境与权限 |
| Claude Code | 高度可编程的终端工程搭档 | CLI 工作流成熟,CLAUDE.md、Skills、Hooks、MCP、Agent Teams 与 CI 组合能力强 |
能力很多,配置面也大;高自治模式下仍需要清楚的权限规则和人工审查 |
| ZCode | Agent-first 的桌面开发环境 | 工作区、文件引用、Git 分支、浏览器验证、Goal Mode 和长任务状态都集中在图形界面 | 更依赖 ZCode 自己的产品界面与 GLM 适配;对纯终端和已有 IDE 重度用户,迁移成本更明显 |
| Kimi Code | 轻量、开放、中文友好的终端 Agent | 单文件安装、精致 TUI、Skills、Hooks、子 Agent、MCP,以及多模型配置都很直接 | 新版本演进快,团队治理与大型组织工作流仍需要自己建立规范和证据链 |
| wcode | Agent 之下的 Repository Control Plane | 跨客户端共享 Design State、Software Graph、授权边界、Risk、Verification、Evidence 与 Reconciliation | 不生成答案,也不替代模型;需要团队愿意把关键工程状态结构化留在仓库里 |
这张表故意没有“代码能力 9.7 分”一栏。模型版本、推理档位、提示词、仓库类型、网络与测试环境都能让这种数字迅速失真。对日常开发更有用的问题是:它能不能在你的项目里稳定完成闭环。
我怎么用 Codex#
Codex CLI 官方文档展示的已经不是一个单纯聊天终端:它能检查和编辑仓库、运行本地工具、做只读代码审查、调用 MCP、使用 Skills 与插件、拆分子 Agent,并通过权限与沙盒限定可写目录和命令。需要离开本机时,Codex 云端还能为多个任务创建隔离环境,并行执行后再把 diff 或 PR 带回来。
我用 Codex 时最顺手的一点,是同一个工作对象可以在多个执行面之间移动。短修复留在终端,界面问题带图片处理,大范围调查交给子 Agent,耗时任务放到云端。它不只是在回答得好,而是在逐渐把代码审查、执行、协作和异步委派放进同一套体验。
它的缺点也来自这种广度。CLI、桌面、IDE、云环境、插件、权限、账户能力同时演进,今天的最佳用法未必是半年前的最佳用法。团队如果只凭默认值一路点过去,很容易拥有很多能力,却没有形成稳定的项目规则。Codex 能跑完整闭环,不等于每个仓库天然就有清楚的验收标准。
我怎么用 Claude Code#
Claude Code 官方概览把它定义为可在终端、IDE、桌面和 Web 使用的 Agent 编码工具。它对成熟开发者工作流的理解很具体:读整个代码库、跨文件修改、运行命令、处理 Git、接入 MCP,并通过 CLAUDE.md、Skills 和 Hooks 固化项目习惯。CLI 又天然适合 pipe、脚本和 CI,这使它很容易嵌进已有工程链路。
我用 Claude Code 时更看重这些机制组合起来之后的可编程性。你可以让 Hook 在编辑后格式化,让 Skill 固化发布流程,让 MCP 接设计稿和工单,再把独立任务分给 Agent Teams。对于愿意维护工程约定的团队,它很容易从“个人助手”长成“团队工具”。
代价是配置复杂度和运行成本都可能随自治程度上涨。权限规则、Hooks、MCP、记忆、子 Agent 都需要治理;配置得越自由,越不能把“模型说完成了”当成完成。Claude Code 很强,但强工具不会自动替团队定义什么叫正确。
我怎么用 ZCode#
ZCode Agent 官方文档强调的是工作区入口:文件与目录引用、历史对话、命令、Skills、模型、执行模式和 Git 分支都围绕任务组织。它还把浏览器控制放进产品里,前端改完可以直接打开页面、点击、截图和验证;Goal Mode 则面向长任务提供目标管理、完成校验和状态恢复。
这套思路对不喜欢终端堆配置的人很友好。尤其是中文用户和 GLM Coding Plan 用户,模型、界面、浏览器与长任务被打包在一起,第一天就能得到相对完整的 Agent 工作台。
但它也是四者中“环境感”最强的一款。如果你已经深度依赖自己的终端、编辑器和脚本体系,就要衡量是否愿意把任务管理和上下文组织迁进另一个桌面产品。它针对 GLM 系列的深度适配是优势,也意味着最佳体验与自家模型路线绑定得更紧。
我怎么用 Kimi Code#
Kimi Code CLI 入门覆盖 macOS、Linux 与 Windows,既能交互运行,也能用单条指令执行;读操作默认直接进行,修改文件或执行命令则请求确认。它支持生成 AGENTS.md,还能配置 Kimi 之外的 Anthropic、OpenAI、Google 等模型来源。
更值得注意的是它的工程扩展面。Kimi Code 文档列出了 Skills、Hooks、子 Agent 和 MCP,并提供单文件安装与 TUI。也就是说,它不只是“中文模型加一个命令行壳”,而是在认真做可扩展 Agent。
它的优势很实际:中文交互自然,安装轻,终端体验舒服,会员与 API 两条路径清楚,多模型配置给了用户选择权。短板则是生态仍在高速生长。个人使用可以很快,到了多人协作、审计、跨客户端一致性和长期证据保存,仍要靠团队自己补齐工程制度。
wcode 放在另一层#
上面四款工具都负责执行任务。wcode 留在它们下面,保存我不想跟客户端一起更换的仓库状态和边界。
Codex / Claude Code / ZCode / Kimi Code / Web AI
                         │
                    MCP / stdio
                         ▼
┌──────────────────────────────────────────┐
│                  wcode                   │
│ Design State · Software Graph · Risk     │
│ Verification · Evidence · Reconciliation │
│ Workspace boundary · Authorization       │
└───────────────────────┬──────────────────┘
                        ▼
                  Git repository
1. 状态跟 Git revision 走#
Agent 通常从一次会话获得目标,整理上下文,然后执行。会话可以恢复、压缩或迁移,但它仍然属于某个产品。wcode 把状态锚定在仓库和 Git revision:设计、影响分析、验证计划与证据都围绕当前代码版本组织。聊天结束不会让这些事实失去归属。
2. 权限边界留在仓库工具层#
Codex 有沙盒与审批,Claude Code 有 Permission Mode,ZCode 有执行模式,Kimi Code 会在修改和命令前确认。这些机制主要决定“当前 Agent 能不能做”。
wcode 进一步决定“这个操作即使被允许,也必须满足什么条件”:路径必须留在 Workspace,禁止 shell 解释器,受保护路径不能绕过,文件修改要带 SHA-256 前置条件,破坏性仓库操作要绑定精确指纹,命令输出和执行时间有边界。测试要跑、shell 不给:验证有自己的专用通道,可以跑批准过的检查、测试和构建,而不需要放开任意命令执行。Agent 可以换,不变量不能换。
3. Context 带来源和精度#
把更多文件塞进长上下文并不等于理解项目。wcode 会区分 Tree-sitter 的语法关系和 LSP 等 Provider 给出的语义事实,记录来源、精度、源码哈希与新鲜度。旧 revision 的语义结果会变成 stale,而不是继续伪装成当前事实。语义查询的结果也分得清“不支持、这次失败了、确实没有”——失败永远不会被伪装成“没有引用”的语义证据。
4. 完成要留下 Evidence#
“tests passed”在聊天里很容易说,难的是几天以后证明:运行了哪条命令、针对哪个 revision、哪个阶段通过、有没有独立 reviewer、是否仍有互相冲突的证据。wcode 的 Verification 与 Evidence 就是为了把完成声明变成可检查的产物。而且门禁是 fail closed 的:一个 producer 的 Pass 盖不住另一个的 Fail;多个模型意见一致,也只是模型证据,不是确定性证明。
5. 设计漂移单独处理#
Agent 擅长回答“下一步改什么”。wcode 的 Reconciliation 关心另一件事:Desired State、Software Graph 与 Git Actual State 之间哪里已经不一致,哪些差距需要回写设计,哪些需要补实现或验证。这个循环面向项目寿命,而不是单次对话寿命。
6. 任务可以换模型接着做#
Agent 的任务状态基本活在会话里:会话断了,进度、待办和理由一起断。wcode 把它们变成仓库状态:工作清单、执行计划、审查任务都持久保存、可认领、可交接。一个模型做实现,另一个做安全审查,第三个补测试,面对的是同一个计划、同一个 revision、同一组证据,不需要共享任何聊天记录。而真正需要人和确定性检查的关口,模型根本认领不了。
我最后保留下来的好处很具体:换 Agent 不用重建项目记忆;Context 能追到来源;权限由同一层执行;验证结果绑定 revision;Design State 和代码分叉时有地方看。模型本身变强当然有帮助,但这些仓库问题不会因此自动消失。
我的实际选择#
如果是个人项目,我会这样选:需要本地、桌面、IDE 与云端任务来回切换,先用 Codex;终端自动化、Hooks、MCP 和团队约定已经很重,Claude Code 仍然非常稳;想要一体化中文 Agent 工作台和浏览器验证,试 ZCode;想要轻量 TUI、中文体验、多模型和开放扩展,Kimi Code 很值得装。
如果是一个会持续半年以上、会被多人和多个 Agent 反复修改的仓库,我不会只选其中一个。我会选一两个主力 Agent,再把 wcode 放在下面。
如果你已经有顺手的 Coding Agent,不需要为了试 wcode 迁移模型。拿一个熟悉的仓库跑 wcode setup,继续用原来的 Codex、Claude Code 或其他 MCP Host,然后看三件事:它能不能找到需求对应的实现,能不能说明当前 diff 影响了什么,验证结果是不是还匹配现在的 revision。
这三件事对我有用,我才一直把 wcode 留在长期项目里。